Có một đêm mình bị đánh thức bởi tin nhắn: API xử lý ảnh trả lời chậm "như rùa". Mở bảng theo dõi ra coi, con số làm mình tỉnh ngủ hẳn: p50 vẫn 40ms bình thường, nhưng p99 từ 45ms vọt lên 2.1 giây. Kỳ lạ hơn: CPU của container chỉ chạy 18%, RAM phẳng lì, log không một dòng lỗi.
Một service chậm mà không đói CPU, không đầy RAM, không lỗi — nghĩa là nó đang chờ cái gì đó. Mà service này đâu có chờ ai: nhận ảnh, resize, đẩy lên S3. Không database, không gọi service ngoài. Vậy nó chờ cái gì?
Bài này kể lại nguyên cái timeline đó, vì mình nghĩ bạn cũng sẽ gặp — nhất là khi mới chuyển sang Rust và tin rằng "async là nhanh".
Triệu chứng: chậm đều đều, không rõ lúc nào
Điều khó chịu nhất là sự cố không liên tục: cứ có người upload ảnh hàng loạt là API chậm, restart pod thì hết. Chính vì restart là hết nên cả team đoán mò suốt mấy ngày — chắc do S3, chắc do mạng.
Sau vài ngày, mình gom lại ba dữ kiện:
- p99 tăng vọt đúng những lúc có nhiều request upload cùng lúc.
- Số request đang xử lý tăng vọt, nhưng CPU không tăng theo.
- Request đơn lẻ chạy một mình thì nhanh bình thường.
Ba dữ kiện đó chỉ về đúng một hướng: tài nguyên bị giữ chỗ mà không ai xài. Trong async runtime, thứ bị giữ chỗ đó chính là thread.
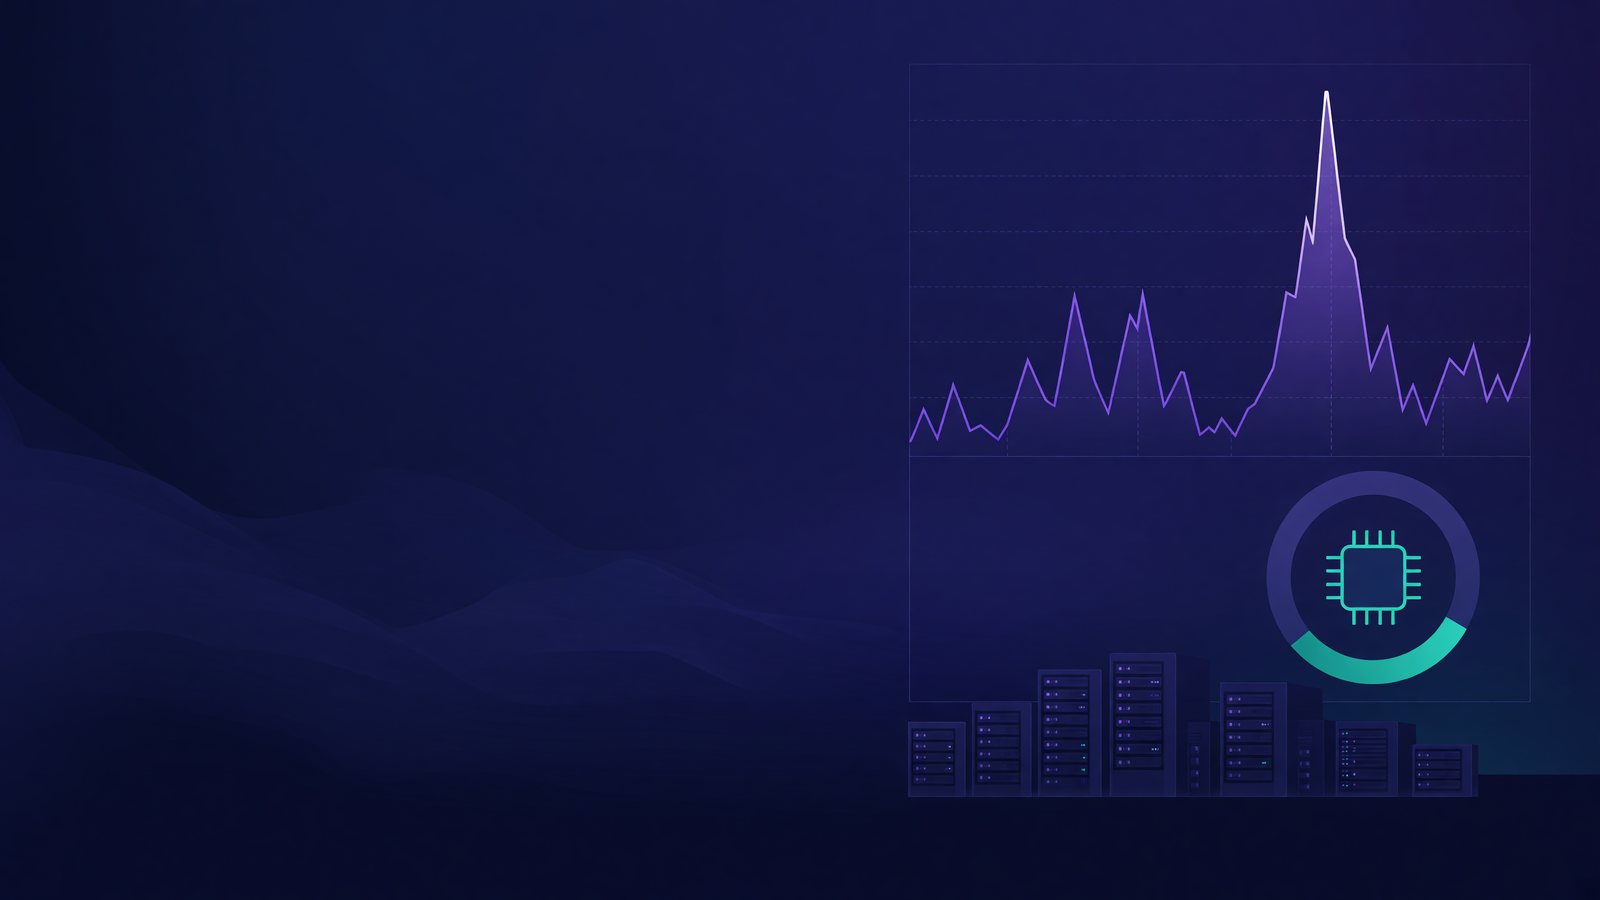 Ảnh: Đường latency nhảy vọt trong khi đồng hồ CPU vẫn nằm ở mức thấp — cặp tín hiệu trái ngược này là dấu hiệu kinh điển của việc thread bị giữ chỗ mà không làm gì. Mình vẽ lại đúng trạng thái bảng theo dõi đêm hôm đó.
Đo cái mình chưa từng đo: thời gian chờ được poll
Mọi dashboard đều đo thời gian xử lý request, không cái nào đo thời gian task phải chờ trước khi được chạy. Trong Tokio, một future chỉ chạy khi có worker thread rảnh để poll nó.
Nên mình thêm đúng một phép đo, ngay chỗ spawn task:
use std::time::{Duration, Instant};

let submitted = Instant::now();

tokio::spawn(async move {
    // future đã tạo, nhưng tới đây mới được poll lần đầu
    let waited = submitted.elapsed();
    if waited > Duration::from_millis(50) {
        tracing::warn!(?waited, "task phải chờ lâu mới được poll");
    }
    handle_upload(bytes).await
});
Chạy lại đúng đợt upload hàng loạt: hàng trăm dòng waited=1.8s. Không phải S3, không phải mạng. Task nằm trong hàng đợi gần hai giây mới có thread nhận. Worker thread của runtime bị chiếm sạch.
Root cause: blocking nằm ngay trong async fn
Mở handler ra thì thấy chỗ sai nằm ngay dòng đầu:
async fn handle_upload(bytes: Bytes) -> Result<Url, Error> {
    // CPU-bound, blocking thật sự — nhưng nằm trong async fn
    let img = image::load_from_memory(&bytes)?;
    let resized = img.resize(800, 800, image::imageops::FilterType::Lanczos3);
    upload_s3(resized).await
}
image::load_from_memory và resize là code CPU thuần, không có .await nào. Với ảnh 12MP, riêng bước resize ngốn khoảng 600ms CPU. Tokio mặc định tạo worker bằng số core — máy 4 core thì 4 worker, nhận 4 ảnh nặng là cả runtime đứng hình, mọi request khác xếp hàng phía sau.
Đau hơn là có một chỗ thứ hai, kiểu sai mà ai viết Rust async cũng từng dính ít nhất một lần:
// sai: std::sync::Mutex giữ lock xuyên qua .await
let mut guard = shared_cache.lock().unwrap();
guard.insert(key, meta);
upload_s3(data).await?; // guard còn sống tới đây
std::sync::Mutex không biết gì về async. Giữ nó qua .await là một worker thread bị khoá cứng trong lúc chờ IO — đúng nghĩa "ngồi không mà vẫn chiếm ghế".
 Ảnh: Một ống dẫn duy nhất bị nút kín, dòng hạt phía sau dồn ứ lại dù đường ống bên cạnh vẫn trống — hình ảnh của một worker thread bị chặn làm cả runtime ùn tắc. Trong bài, "nút chai" đó chính là hàm CPU-bound chạy thẳng trong async task.
Sửa: đẩy việc nặng ra khỏi runtime
Nguyên tắc duy nhất cần nhớ: code blocking thì phải chạy trên thread riêng, không được nằm trong async task. Tokio có spawn_blocking đúng cho việc này:
let resized = tokio::task::spawn_blocking(move || {
    let img = image::load_from_memory(&bytes)?;
    Ok::<_, image::ImageError>(img.resize(800, 800, FilterType::Lanczos3))
})
.await??; // một ? cho JoinError, một ? cho lỗi xử lý ảnh

upload_s3(resized).await
Còn chỗ cache thì đổi sang mutex của Tokio, hoặc gọn hơn — thu hẹp phạm vi lock để nó chết trước khi tới .await:
{
    let mut guard = shared_cache.lock().unwrap();
    guard.insert(key, meta);
} // guard drop ở đây
upload_s3(data).await?;
Thêm hai thứ nữa mình học được từ vụ này: bật lint clippy::await_holding_lock để compiler bắt hộ lỗi giữ lock qua await, và dùng Semaphore giới hạn số việc CPU nặng chạy cùng lúc — spawn_blocking cũng có pool giới hạn, nhồi quá thì nó thành cái hàng đợi mới.
 Ảnh: Việc nặng được cần cẩu phụ nâng sang làn xử lý riêng, còn làn chính chạy thoáng trở lại — đúng vai trò của `spawn_blocking` đối với async runtime. Sau thay đổi này p99 của mình rơi từ 2.1 giây về 60ms.
Bài học
asynckhông làm code nhanh lên, nó chỉ giúp chờ đợi rẻ hơn. Việc CPU-bound vẫn tốn đúng ngần ấy CPU, và nếu để nó trên worker thread thì bạn đang lấy thread của cả hệ thống ra đốt.- p99 xấu mà CPU thấp là tín hiệu starvation, không phải tín hiệu "hệ thống khoẻ". Mình từng đọc ngược tín hiệu này suốt mấy ngày.
- Đo thời gian chờ được poll, đừng chỉ đo thời gian handler. Request chậm 2 giây có thể chỉ xử lý 50ms, phần còn lại là xếp hàng.
- Đừng giữ lock qua
.await, và nhớstd::sync::Mutexvớitokio::sync::Mutexkhông thay thế nhau được.
Bạn có đang chạy service Rust mà p99 thỉnh thoảng nhảy loạn không? Thử thêm đúng cái log đo thời gian chờ ở trên, biết đâu lại thấy thủ phạm nằm ở một dòng spawn bạn viết từ năm ngoái.
📋 Phụ lục thuật ngữ
- Runtime (Tokio) — thư viện chạy các future bất đồng bộ, quản lý pool worker thread.
- Worker thread — thread thật của runtime, rảnh thì lấy future ra poll.
- Poll — một lần runtime hỏi future "chạy tiếp được chưa".
- Blocking call — hàm chiếm trọn thread tới khi xong, không nhường cho ai (đọc file, tính toán nặng…).
spawn_blocking— đẩy closure sang pool thread riêng dành cho việc blocking, giữ runtime rảnh.- Starvation — worker thread bị chiếm hết, future mới không có ai poll.
Semaphore— bộ đếm giới hạn số task chạy đồng thời.